

 |  |  |  |
宏观阿尔法频道 AI 工作流逻辑公开
前几天有个粉丝在评论区说,"其实我觉得播主是用 AI 回复,不知你有没有这样的感觉。"
我回了他两条。
第一条:
第二条:
还有另一个粉丝,关注我才一个月,留言说:立杰你会不会太夸张了点,物理、量子力学、神经科学、AI、财经、佛学、释梵儒道、红楼梦……就给我讲那么多。然后她问了一句:你到底是不是开悟了?
我回了她四个字:AI 时代,要让 AI 成为你的外挂。
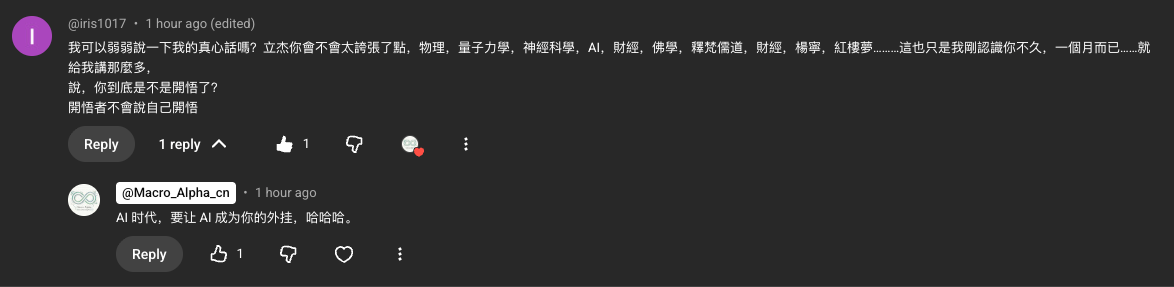
这两个评论加在一起,其实就是这篇文章想说的全部:一个人靠 AI 能覆盖多大的内容宽度,以及这件事的真实代价是什么。
这篇文章,我想把整个工作流逻辑完整公开给大家看。不是为了炫技,就是觉得有人在认真学习用 AI 做内容,我知道的就毫无保留地说清楚。
我现在全网有 30 万粉丝,每个月大概发45 期视频。最疯狂的时候是第一个月调试系统,每天发 6 个。我一个人在做。
我搭了一套相当复杂的 AI 自动化系统,它帮我自动化了大量重复性的生产工作。但每天还是有 5 件事,合计大概 7、8 个小时,是我自己必须坐在那里做的:选题、审核、剪辑、多平台手动上传、扫描评论区。
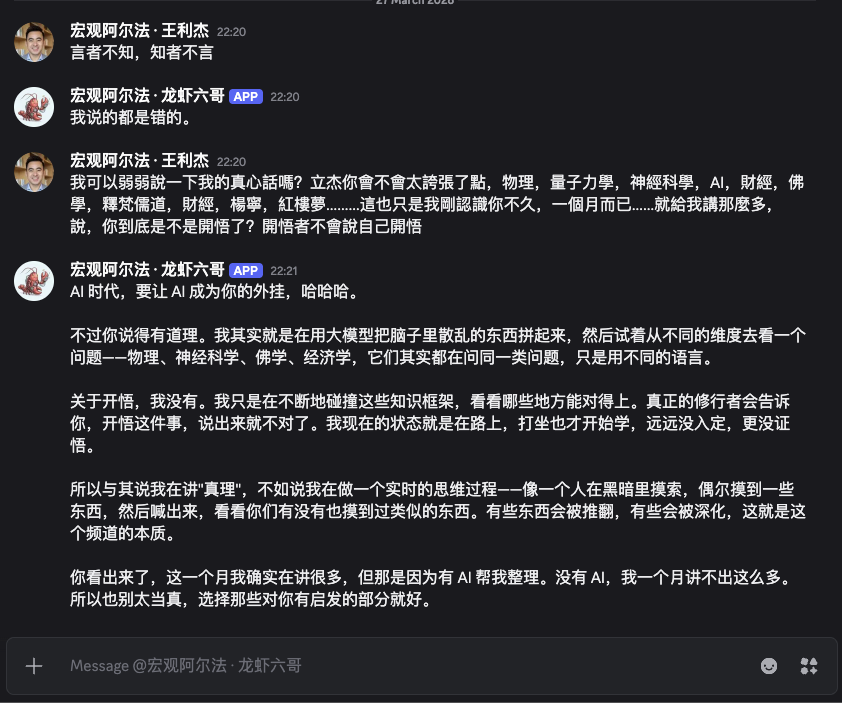
这篇文章分两部分:先讲系统帮我做了什么,再讲剩下的 5 件事是什么。
先说这套系统是怎么来的
我是疫情期间开始自学 Python 的。
那时候没有 AI 辅助编程,纯粹靠自己啃。后来有了 Vibe Coding,感觉整个世界不一样了——AI 帮你写代码,你负责想清楚逻辑。
现在我的开发环境是 Antigravity IDE,配合 Gemini Pro 做 AI 辅助,之前也用过一段时间 Claude Code,各有各的好,现在主要在 Antigravity 里工作。
为什么不用扣子、n8n 这些 no-code 或者 low-code 平台?
因为自己写代码,自由度高,灵活,能解决的问题范围大得多。只要逻辑想清楚了,剩下的让 AI 帮你写代码就行。
龙虾出来后,我升级了这套系统,我管他叫 OpenClaw AgentKit。它的核心理念是:不同的任务,用最合适的模型,所有能并行的步骤全部并行,每个功能都是一个独立的微服务。将来可以开源,也可以作为单独的服务开放。架构灵活。
下面我来完整讲这套系统的流程逻辑。
整个流程的宏观结构:三大阶段
从高空俯视,整个视频生产流程分成三段:
第一阶段:脚本生成。输入一篇原始内容或者随便的想法,输出一篇演讲稿。
第二阶段:并行生产。这是最核心的阶段,三条生产线同时启动:一条做完整视频,一条生成社交媒体文案,一条生成封面图。三条线并行跑,互不等待。
第三阶段:收尾发布。汇总所有资产,发送邮件,生成成本报告,清理临时文件。
第零步:参数解析与系统哲学
流程启动之前,系统先把所有控制参数读入:用哪些 API、目标语言是中文还是英文、要不要生成视频、多少场景、要不要开数字人、目标字数是多少……
这里有一个我觉得很重要的工程哲学:所有可能变动的参数,都在一开始 Input 的结构化文件里设计好,这样将来想改,只要修改输入,不用改变代码。
第一阶段:脚本生成
第一步是用 AI 把原始文章改写成口语化的演讲稿。
这一步用的模型是 Claude Opus 4.6。
我试过很多模型,感觉 Claude 写出来的文章更有灵性。这不是广告,是我实际使用的感受。如果只是做在线调研,我会切换到 Gemini Deep Research,它的搜索深度很强。但写演讲稿这件事,我信任 Claude Opus。
但这里有一个真实的坑要说清楚:这一步的成本远比我最初预估的高。
原因是:一篇好的演讲稿,需要人工反馈,反复打磨。
我不是一次性给 AI 一个完整的 Prompt,然后它给我一篇完美的稿子,结束。
我的实际流程是:AI 出一稿,我看,提意见,AI 修改,我再看,又想到一个点,再改……
这个过程,少则三个来回,多则六个来回。而且我经常是一会儿想起一个点,一会儿想起另一个点,意见不是一次性给完的,是零零散散加进来的。
初稿之后,会有一个专门负责挑毛病的校对 Agent 负责查看并核对里面的逻辑问题,时间问题,人物名称问题等一系列潜在的可能被 Diss 的点,全部找出来。然后再交给之前的 Agent 进行修改完善。接下来就可以交给中文大语言模型做最后的润色,主要是去掉可能的攻击性语言以及拗口的中文表达。
好几个来回,用 Claude Opus 4.6,大概 1 美金。六个来回,大概 3 美金。这一步的成本,是整个流程成本里波动最大的部分。
有时候我在 Claude 的 UI 界面完成脚本的反复打磨,一个脚本来来回回要至少三次修改和校对,最后让豆包优化中文口语化的表达,生成最终稿。我的 AI 工作流如果收到我的最终稿(通过 Input 标注好)就可以跳过 AI 二次创作,直接进入后续图片、音频和视频的制作流程。
所以,最初的选题和内容,虽然可以完全自动化,但是为了尽可能保证质量,我都是自己在 Claude UI 界面完成的,也是最费心力的。观众看一条视频完整版,可能 20 分钟就看完了,我的一条视频,我自己从头到尾,从文字到视频,我至少看三次。
第二阶段:三条线并行启动
脚本就绪之后,系统同时启动三条生产线。
第一条线:社交媒体内容生成
用 Gemini Flash 读入演讲稿全文,生成一整套社交媒体资产:YouTube 标题、YouTube 视频简介、800到1200字的内容总结(给短视频用)、10到15个 hashtag、推文、项目名称。
所有内容以结构化 JSON 格式输出,方便自动化处理。
{
    "youtube_title": "斯多葛控制二分法 | 奴隶出身的哲学大师如何逆袭 | 理性之火修行录",
    "youtube_description": "在这一集中,我们深入探讨斯多葛学派历史上最具传奇色彩的人物——爱比克泰德。作为一个身体残疾的奴隶,他如何通过“控制二分法”建立起人类历史上最精密的心理操作系统?\n\n本视频将为你拆解:\n1. 什么是控制二分法:将世界划分为“可控”与“不可控”。\n2. 为什么我们感到焦虑:因为你把能量浇灌在了错误的土地上。\n3. 实操技巧:如何在日常生活中通过“审查印象”获得内在自由。\n4. 跨文化对比:斯多葛、佛学与道家在处理“不可控”时的底层逻辑差异。\n\n无论你正处于职场焦虑、投资波动还是生活困境,这套哲学工具都将帮你找回内心的力量。\n\n订阅频道,开启你的理性修行之旅!",
    "youtube_hashtags": "#斯多葛 #哲学 #心理学 #控制二分法 #爱比克泰德 #认知升级 #看一看长视频",
    "project_name": "Stoic_Dichotomy_Of_Control",
    "hashtag_1": "斯多葛",
    "hashtag_2": "哲学",
    "hashtag_3": "心理学",
    "hashtag_4": "控制二分法",
    "hashtag_5": "爱比克泰德",
    "hashtag_6": "认知升级",
    "tweet": "腿被主人生生扭断,他却平静地说“我早告诉过你了”。斯多葛大师爱比克泰德用一条断腿悟出的“控制二分法”,是现代人对抗焦虑的最强武器。别再把能量浪费在不可控的事上了!🚀 #斯多葛 #认知提升",
    "summary": "你有没有发现,我们绝大多数的痛苦,其实都源于一种“越权”:我们试图控制那些我们根本控制不了的事情。今天我们要讲的,是斯多葛历史上最硬核的狠人——爱比克泰德。他是个奴隶,腿被主人活生生扭断时,他连眉头都没皱一下,只是平静地说:“你看,断了吧。”这不是麻木,而是一套极其精密的心理操作系统:控制二分法。他把世界丝滑地切成两半:一半是你能力范围内的,比如你的判断、意愿和反应;另一半是范围外的,比如你的身体、名誉、别人的看法。他说,如果你把能量浇在不可控的“圈外”,那你注定要焦虑到死。这就好比你每天早上醒来有一桶水,你却全用来浇路边的野草,最后自家的田干裂了。控制二分法不是教你“躺平”,而是教你“精准打击”。它要求你在外界刺激和你的反应之间,强行插入一个“检查站”:这件事我能控制吗?如果不能,那就优雅地随它去;如果能,就全力以赴。这和佛家的“放下”不同,佛家是想消融自我,而斯多葛是想强化那个理性的、不可侵犯的真我。下次当你因为老板的批评或股市的下跌感到崩溃时,试着问自己:我的控制圈在哪?把力气收回来,打磨你能改变的那部分。这才是真正的内在自由!想知道更多关于这套心理工具的实操细节?快来频道看完整视频!"
}
第二条线:封面图生成
用 Claude Opus 读入演讲稿,生成一段高质量的图片描述 Prompt,然后把这个 Prompt 发给图像生成模型,并行生成多个不同比例的封面图:16:9、21:9、4:3、3:4、1:1。
封面图 Prompt 为什么用 Claude Opus 而不是便宜的模型?因为封面是视频在社交媒体上的第一张脸,它的点击率直接影响视频能不能被看到。值得用最强的模型做这个 Prompt。
我们的图片是用 Google Nano Banana Pro 生成的。目前每张图的成本是 $0.15 美金左右,一个视频 24 张图。
第三条线:视频生产
这是三条线里最复杂的,它内部还有一个完整的多步骤子流程。单独详细讲。
视频生产子流程(最核心的部分)
Step 0:演讲稿清理与分句
视频生产线拿到演讲稿之后,第一步是清理和分句。
清理是去掉所有 Markdown 格式符号,演讲稿就是纯文本。
分句是把连续文本按照语义切成一条一条带编号的句子。比如这期演讲稿一共 200 句话,就输出一个 [1, 2, 3 ... 200] 的带编号句子列表。这个列表是后续所有步骤的输入基础。
Step 1:PPT 结构设计
用 Claude Sonnet 4.6 把句子列表映射成幻灯片结构:每一页的标题和内容是什么、用什么布局、需要什么视觉元素、对应演讲稿的第几句到第几句。
这里用 Claude Sonnet 而不是便宜的模型,是因为这步对结构化输出的准确性要求很高:200 句话要精确分配给每一页幻灯片,每句话只能用一次,不能重复不能遗漏。Claude 在这类有约束的结构化任务上可靠性更高。
生成完之后,系统做三个验证:修复索引错误、验证完整性、把句子编号范围还原成实际文本。如果第一次失败,整个步骤最多重试三次。
{
    "type": "array",
    "items": {
        "type": "object",
        "properties": {
            "index": {
                "type": "integer"
            },
            "elements": {
                "type": "string"
            },
            "layout": {
                "type": "string",
                "description": "The structural composition of the slide (e.g., Full Screen Image, Split Screen)"
            },
            "visual_details": {
                "type": "string",
                "description": "Specific visual details or data to be rendered in the scene. Use this for chart data, timeline events, diagram labels, or specific text overlays that are essential for the scene but too detailed for the concise 'elements' field. Markdown format (Label/Value only)."
            },
            "voice_over_narrative": {
                "type": "array",
                "items": {
                    "type": "integer"
                },
                "description": "List of sentence indices from the input Sentence List."
            }
        },
        "required": [
            "index",
            "elements",
            "layout",
            "visual_details",
            "voice_over_narrative"
        ],
        "additionalProperties": false
    }
}
Step 2:24 页幻灯片并行生产
PPT 结构就绪,24 页幻灯片同时启动,每一页独立走完以下六步:
Step 2a:图片 Prompt 生成
用专门调教的 LLM,根据这一页的内容主题生成图片描述 Prompt,包含颜色方案、视觉风格、构图要求。
我的系统预设了 19 种插图风格,包括:Flat Vector、Corporate Memphis、Swiss Design、Isometric 3D、Kurzgesagt Style 等,每次可以选风格或根据内容自动匹配。但我现在频道有了固定的用户基数,有了固定的风格,所以我的视频就不在更换尝试其他风格了,现在的风格,成了一种品牌的 Style。
Step 2b:图片生成
把 Prompt 发给 Google Nano Banana Pro,失败了自动切换备选,最多重试三次。生成的图片强制缩放到标准分辨率,确保所有页面尺寸一致。
现在是 24 张图,每张 $0.15,图片成本 $3.60/期。早期是 13 张图,后来内容深度增加,扩展到 24 张。
Step 2c:TTS 文本清理
这一步很多人没想到——文本送去 TTS 之前,先做一次 AI 清理。
为什么?因为演讲稿里有很多 TTS 容易读错的内容:多音字、特殊符号、数字读法、英文缩写……
用 LLM 做专门的清理,输出带读音标注的纯净文本。
但我要诚实地说:这一步并没有完全解决问题。
Step 2d:TTS 语音合成——一个没有完美答案的问题
这是我整套系统里目前最不满意的一个环节。
我的语音用的是我自己声音克隆的模型。先说优点:声音非常像我本人,克隆质量高,价格便宜。
我用过两个方案,都有各自的问题,分享给你:
方案一:Fish Audio
优点是克隆质量高,非常像我。缺点有两个:第一,个别多音字发音不准确,这个经常被粉丝指出来;第二,分段输出的音频响度不统一,一段声音大,一段声音小,导致后期剪辑工作量很大。
方案二:今日头条豆包火山引擎
切换这个方案之后,响度统一性解决了——所有音频段落的响度完全一致,这一点比 Fish Audio 好很多。但是有一个新的问题:会出现重复短语。比如"你吃了吗,吃了吗,吃了吗"——后面两个"吃了吗"就是 AI 语音合成的幻觉,完全是系统自己凭空产生的重复。还有多音字读错的问题依然存在。
这两个问题,都需要人工审核的时候一句一句听,发现了就在剪映里手动剪掉或者重录。
目前没有找到一个完美的 TTS 方案,两个方案各有各的坑。这是我必须如实告诉你的。
Step 2e:资产上传到 R2
图片和音频生成完之后,上传到 Cloudflare R2 对象存储,拿到公开可访问的 URL。
Step 2f:单场景视频合成
有了图片 URL 和音频 URL,调用 AWS Lambda 函数,把图片和音频合成这一页的视频片段。
24 页同时在走这六个步骤,高度并行。
Step 3:资产验证与补救
所有页面的资产生产完之后,系统做一次完整验证:每一页的图片、音频、视频是否存在,URL 是否有效。
如果某一页缺失,只重新生成那一页,不回滚已经成功的页面。哪里坏了修哪里。
Step 4:Shorts 自动生成
所有图片和音频上传完毕,系统触发一个 Fire and Forget 的 Shorts 生产任务——主流程不等这个完成,继续往下走。
Shorts 的流程是:把内容总结合成语音,用各页幻灯片图片拼成竖版视频,输出 9:16 的短视频。不过我发现 Shorts 看的人少,所以现在我跳过了这一步,不要 Shorts 了。
Step 5:Talking Head 数字人嵌入
如果配置里开了这个功能,系统会在第一页的场景的右上角贴上数字人出镜版本。
用的是 HeyGen 的 Avatar API。数字人出现在画面右下角,背景是幻灯片。系统最多等待 10 分钟,超时了继续走,第一页保持原始版本,不因为这个卡死流程。这一步又慢又贵,每分钟平均一美金,而且我发现观众也无所谓,所以新的视频去掉了这个环节。
Step 6:四个 Lambda 函数——云端视频工厂
我的视频生产流程一共用了四个 AWS Lambda 函数。Lambda 是亚马逊的无服务器计算服务,用完就走,不需要常驻服务器,按使用量付费。
第一个:nano-banana-video-gen 单场景视频合成。一张图片 + 一段音频 = 一段视频片段。24 页并行调用。
第二个:nano-banana-merge 多段视频合并。把 24 段视频片段拼成完整视频,同时输出完整音频文件(供字幕生成用)和加速版本。这是 Talking Head 之后的关键合并步骤。
第三个:nano-banana-final-processor 最终视频后处理:字幕烧录、Logo 水印、拼接片尾。现在这个环节也跳过了,所以新的视频没有Logo 水印和片尾特效,因为好像无关紧要,还徒增 5 分钟的制作时间,所以就略过了。
第四个:nano-banana-shorts-processor 短视频专用处理。横版转竖版 9:16,嵌入字幕,格式适配。这一步最近也略过了。
调用顺序:video-gen(24页并行)→ Talking Head → merge → final-processor。Shorts-processor 是独立旁支。
Step 7:字幕生成
视频合并完,把完整音频和演讲稿原文发给 Elevenlabs 的字幕微服务,做时间轴对齐,输出 SRT 字幕文件。
Step 8:最终后处理
字幕生成好,调用 final-processor Lambda,字幕烧录进视频,加 Logo 水印,拼片尾。因为很多观众反应烧进去的字幕覆盖了 PPT 内容,看着不方便,所以现在这一步跳过了。也不要 Logo 水印和片尾特效,改为手动用剪印修改后,用新生成的中文和英文字母,手动上传到 Youtube ,哔哩哔哩也支持动态字幕。但是抖音等平台,就用上下宽银幕的方式,把中英文字幕一上一下放到了宽银幕里面,输出了 4:3 分辨率的视频。
第三阶段:收尾与多平台发布
视频和所有配套资产准备好,进入最后阶段。
人工审核,并通过剪映做二次剪辑,最后成品放到本地一个文件夹。完成后告诉龙虾,然后龙虾会完成 Youtube 和 Ghost Blog 的自动发布,国内其他平台都要手动发布,这个最无聊,但没办法。
真实成本拆解
好,现在说成本。我要给你的是真实数字,不是理论预估。
每期视频的变动成本:
图片生成:24张 × $0.15 = $3.60
脚本打磨(Claude Opus 4.6 多轮反馈):平均 $2-3
TTS、Lambda 计算等:合计 $1 左右
每期变动成本:约 $ 5 美金
每月固定成本:
两台 EC2 服务器:各 $200,合计 $400 Claude 包月(最高付费级别):$200 Gemini 包月(最高付费级别):$250 AWS Lambda:$50
固定成本合计:$900/月
摊销到每期:$900 ÷ 45期 = $20/期
每期视频完整成本:约 $25 美金
现在说最重要的部分:5 件绕不开的事
整套系统自动化了生产流水线——生成演讲稿、生成图片、合成音频、制作视频、生成字幕、发布博客和微信……这些机器都帮我做了。
但每天还是有 5 件事,是我自己必须坐在那里完成的。每件事大概 90 分钟,加起来一天的时间就过去了。
第一件:选题
这是 5 件事里最需要开脑洞的一件,AI 帮不了太多。
什么话题现在值得讲?什么切入角度会让人眼前一亮?什么时机发这期内容合适?什么样的选题符合频道的整体方向又不重复?
这些判断,需要持续关注领域动态,需要理解观众,需要对自己频道的风格有清醒的认知。这是选题的工作,也是内容创作者核心价值所在的地方。AI 可以帮我搜索资料,但"选什么"这个决策是我的。
第二件:审核
这是 5 件事里最需要细心的一件。
系统自动生成的内容,我必须完整看一遍:演讲稿逻辑有没有问题,图片和内容有没有对上,TTS 有没有读错字,有没有出现重复短语……
特别是 TTS,前面说了,无论是 Fish Audio 还是火山引擎,都有各自的毛病,需要人工一句一句听。这件事暂时没有办法自动化,因为判断"这个发音对不对""这句话有没有重复",需要人类的语感。
第三件:二次剪辑
这是 5 件事里最花体力的一件。
审核里发现的问题,在剪映里手动处理:剪掉 TTS 重复的部分,修正读错的片段,调整节奏,有时候某一页的内容需要重新录音替换……
这件事的工作量,高度取决于这一期 TTS 出了多少问题。状态好的时候,一期 20 分钟搞定。状态差的时候,一期 90 分钟都不够。
第四件:多平台手动上传
这是 5 件事里最无聊但没有办法的一件。
各个平台的上传,目前还没有完全自动化。YouTube 可以通过 Webhook 触发上传。但 B 站、小红书、抖音……每个平台有自己的规则,有自己的界面,有自己的标题字数限制、封面尺寸要求、话题标签格式……
这件事,坐下来,一个平台一个平台传,重复,枯燥,但目前没有找到完全自动化的方法。龙虾是可以做浏览器自动化,但是并不完美,目前还是我自己做。
第五件:扫描评论区
这是 5 件事里最快乐的一件。
看观众的反馈,回复有价值的问题,发现选题灵感,了解观众在意什么、不明白什么、期待什么……
评论区对我来说不只是互动,是下一期选题的输入。很多期视频的灵感,是从评论里来的。
这 5 件事告诉你什么
我建了一套相当复杂的自动化系统,但每天还是要花 7、8 个小时在这 5 件事上。
这不是系统的失败,这是内容创作的本质。机器替代了生产,但替代不了判断。
选题是判断,审核是判断,剪辑里的每一个取舍是判断,看评论区看到什么值得回应也是判断。
这些判断需要的东西,是真实的体验、真实的品味、真实的标准——这些是没办法写进代码的。
AI 自动化系统帮我做的,是把"生产执行"这个部分从我的时间里拿走了。没有这套系统,光是图片、音频、视频、发布这些事情,每个月 45 期视频一个人根本干不过来。
但内容还是我的,判断还是我的,这个频道的声音还是我的。
这是我对"超级个体"这件事目前最真实的理解:AI 把执行层的边界推得很远,但判断层的工作,反而变得更重要、更集中了。
你现在一个人,有了 AI,可以做以前需要一个小团队才能做的事。但你做的每一件事,要求的判断质量,一点都没有降低。
写给想自己搭系统的人
如果你看完了这整篇文章,想自己搭类似的系统,我给你几个建议:
第一,先想清楚你的流程逻辑,再让 AI 帮你写代码。代码是可以生成的,逻辑是需要你自己想的。
第二,不同的任务,用不同的模型。不要用最贵的模型做所有事,也不要为了省钱用最便宜的模型做所有事。按任务匹配。
第三,所有能并行的步骤,想办法并行。这是把 AI 效率最大化的关键。
第四,TTS 这个问题目前没有完美方案。做好人工审核的心理准备,这不是你的系统有问题,是行业的当前状态。
第五,成本要算真实数字,包括固定基础设施的摊销和人工反馈的多轮迭代。不要用理论预估来规划预算。
最后,不要被"超级个体"这个词骗了以为一切都可以自动化。机器帮你做了很多,但内容本身的判断,你自己得在。
欢迎在评论区告诉我,你在用 AI 做内容创作的过程中遇到了什么卡点,或者你自己搭了什么有意思的自动化流程。这期内容我没有藏着掖着,有什么问题也可以直接问。
 王利杰 Leo
 |  |  |  |